手袋で集めた30分未満の人間データで新しい作業を覚えると主張。Reward AIがロボット方策「OM-1」を公開
Mobile ALOHAやDexCapの研究者が創業したReward AIが、テレオペレーションもロボット実機のデータも使わず、センサー付きの手袋で集めた人間のデータだけで学習するロボット方策「OM-1」を公開した。新しい作業は30分未満のデータで覚えるとする。一方で成功率や試行回数、使った機種は公表されておらず、モデルも非公開。同じ9月にarXivに出たSkel-WAM、DexTouch-WMと並べ、人の手からロボットを学ばせる3つの方法を比べる。
ロボットに作業を教えるとき、いまの主流は人がロボットを遠隔で操縦して手本を記録するテレオペレーションだ。スタンフォード大学出身の研究者が創業した Reward AI は2026年9月、その工程を丸ごと外したロボット方策「OM-1」を公開した。学習に使うのは、センサーを仕込んだ手袋を着けた人の作業データだけ。テレオペも、ロボット実機で集めた経験も入れていないという。
同社によれば、OM-1 は新しい作業を30分に満たないデータで覚え、産業用アームからヒューマノイドまで同じ方策で動かす。公式 YouTube の2分余りの動画には、バーテンダーの作業、ナットを緩める、LANケーブルを抜く、スマートフォンの梱包、洗濯物たたみ、チューブの仕分け、ヒューマノイドによる拾って投げる動作が並ぶ。ブログにはこのほか、ヒューマノイドが閉じた冷蔵庫の扉を開ける動画もある。
手袋が記録するのは、映像より多い
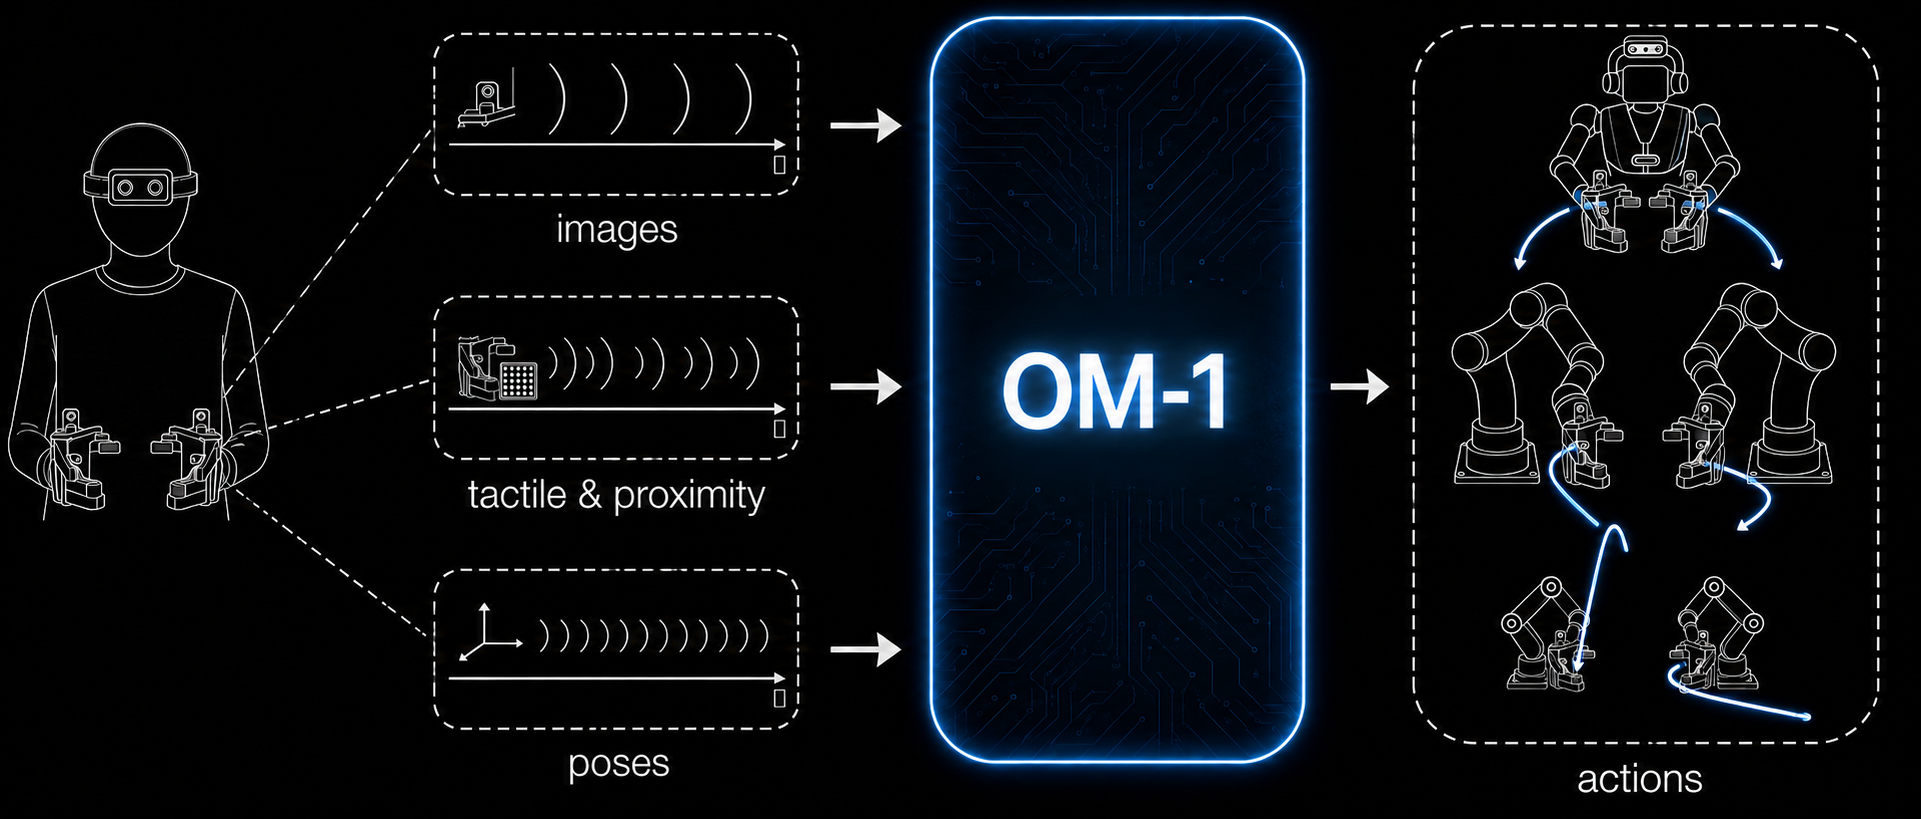
「人のデモだけで学ぶ」と聞くと、人の動画を大量に見せる方式を想像しやすい。OM-1 の入力はそれとは違う。起点は、同社が「Omnibody Hand」と呼ぶ7自由度の装着型の手袋だ。親指と人差し指は個別に、中指・薬指・小指は付け根でまとめて動きを取り、精密なつまみと握り込みの両方を記録する。手の大きさの個人差は機構側で吸収し、着る人ごとの調整は要らないという。
この手袋から取るデータの形式を、同社は「One Data Interface」と呼ぶ。手の中のグローバルシャッターカメラ、高頻度の触覚、接触する直前の距離を測る近接センサー、手の位置の軌跡、押し引きの力を同時に記録する。ベルトコンベヤーの仕分けのように、物を見つけてからつかんで箱に放るまでが1秒足らずの作業では、接触の一瞬を取り逃がすと記録の価値が落ちる。映像だけでは見えにくい「つかむ瞬間」と「しっかり保持できたか」を、触覚と近接で補う設計だ。
手の位置の追跡には、一般的な視覚慣性方式に電磁式のセンサーを加えた。2つの追跡装置を同じ台に固定し、既知の距離にある2つの機械的な止め具の間を8段階の速度で往復させ、各速度10回の平均で行き過ぎの誤差を比べている。最も速い秒速67cmで、平均オーバーシュート誤差は視覚慣性方式の24.9mmに対し9.5mm、約60%の低減だった。人に「ゆっくり動いてください」と頼まずに、素早い動きのまま記録するための工夫である。
「ロボットデータなし」が指す範囲
OM-1 本体は、これらのセンサー列を各センサー本来の周期のまま受け取り、動きの方向、速度、力、つかむ・動かすといった節目のタイミングを出力する。人の動きから直接ロボットの動作を生成し、事前学習と追加学習の区別も置かないという。
その出力を各機体の関節やモーターの動きに落とすのが、下層の制御層だ。こちらはシミュレーション内の強化学習で訓練され、速度や加速度に依存する動力学、外乱、遅延を吸収する。方策とは別の時計で高い周期で回り、推論に時間がかかってもロボットの動きを止めない。
つまり「テレオペなし、実機データなし」は、方策の学習データに実機のデータを入れていないという意味で、シミュレーションを使わないという意味ではない。機体ごとの差を制御層がどこまで吸収でき、新しい機体を足すのにどれだけの手間がかかるのかは、ブログからは読み取れない。
公開されている評価は、ここまで
OM-1 のブログに載る定量値は、前述の追跡誤差の比較だけだ。作業ごとの成功率、試行回数、失敗の内訳、比較対象にした既存手法は書かれていない。動画に映るロボットの機種名も出ていない。同社の紹介ページも、モデルが扱う機体を「ロボットアーム、脚型ヒューマノイド、車輪型のモバイルマニピュレーター」と種類で挙げるだけだ。「30分未満」がどの作業で、どの成功水準に届くまでの時間なのかも示されていない。モデルの重み、コード、データセット、論文は公開されておらず、第三者が再現する手段は今のところない。
同社は「公開する動画はすべて等倍速で、そう明記する」としている。早回しで見せないのは誠実な姿勢だが、動画は成功例を選んで載せられる。8月に動画1本をプロンプトにする方式を公開したSkild AIの「S1」は、少なくとも自社実験の成功率(未学習タスクで言語指示の9%に対し66%)を出していた。OM-1 はそれより手前の段階の開示にとどまる。
人の手からロボットへ、同じ9月に並んだ3つの方法
同じ時期、arXiv には人の手のデータからロボットを学ばせる論文が相次いだ。ただし、どれも実機のデータをゼロにはしていない。
Skel-WAM(2026年9月18日投稿、香港中文大学・上海AI実験室など)は、人の手とロボットハンドを共通の「手の骨格」で表す。映像に骨格を重ね描きし、2.5次元のキーポイントとして手の動きを明示することで、人の動画をロボットの行動ラベルなしで学習に使う。実機は Franka Research 3 アーム2本に RobotEra XHand1 のハンドを載せた構成で、4つの双腕タスクの平均成功率は79.86%。最も強い比較手法 EgoVLA を22.22ポイント上回った。ロボットのデモにない条件(物の位置、手首の向き、紛らわしい物の追加、作業の高さ)を人のデモだけで補った場合、成功率は38.89%から86.11%に上がったという。
ただしロボットのデモは1タスクあたり平均50本をテレオペで集め、人のデモは平均25本だ。試行回数は、ロボットのデモがある条件で24回、人のデモだけで補った条件で9回、新しい背景で6回(いずれも1タスクあたり)。86.11%は4条件×9回の計36回のうち31回の成功にあたる。改善の方向ははっきりしているが、1回の成否で数ポイント動く規模の検証である。
DexTouch-WM(同9月17日、香港科技大学(広州)・Xspark AI・清華大学など)は触覚に焦点を当てる。人とロボットハンドに同じ配置の圧力センサーシートを貼り、人の触覚データ約100時間(50種類の日常作業)とロボットの5時間で、次の映像と触覚を予測する世界モデルを学習した。ロボットのデータを5時間に固定したまま人のデータを0から100時間に増やすと、ロボット側の予測精度が上がった。一方、この世界モデルで生成した合成データを方策の学習に使うと、結果は方策によって分かれた。π0.5 では4タスク平均が実データのみの0.625から0.494に下がっている。
| OM-1(Reward AI) | Skel-WAM | DexTouch-WM | |
|---|---|---|---|
| 人のデータの形 | 触覚・近接・手元カメラ・電磁追跡の手袋 | 人の手の動画と骨格 | 圧力センサー手袋・指と手首の追跡・頭部カメラ |
| ロボット実機のデータ | 使わない(制御層はシミュレーションで訓練) | 1タスク平均50本のテレオペデモ | 5時間+下流タスク用の軌跡 |
| 公表された評価 | 追跡誤差の比較のみ | 実機4タスク、1条件あたり6〜24回 | 予測精度、方策評価(10回×評価者5人) |
| 公開状況 | ブログと動画のみ | 論文とプロジェクトページ | 論文(IROS 2026ワークショップ採択) |
Reward AI の CTO、Chen Wang はスタンフォード大学で手袋型モーションキャプチャ「DexCap」(RSS 2024)を発表しており、Omnibody Hand はその延長にある。CEO の Zipeng Fu は、低コストのテレオペで家事を教えた Mobile ALOHA(CoRL 2024)の著者だ。テレオペの普及に関わった研究者が、約2年半後に「テレオペを使わない」側へ振り切ったことになる。
HuRoC視点
ロボットの学習データは、誰の手から来るのかという問いに移りつつある。XDOF はジャカルタに収集と監査の部隊を置いて両腕テレオペのデータを集め、Generalist AI は装着型デバイスで人の活動データを集める。日本でもタイミーとジールスがデータ収集をスポットワークにする構想を出した。OM-1 の方式が本当に機能するなら、データを作る人はロボットの操縦を覚える必要がなく、手袋を着けて普段どおり働けばよくなる。
大田区の町工場で、熟練した職人がねじを締め、部品をはめ、布をたたむ。その手元の力加減と接触のタイミングが、そのままロボットに移せる形で記録できるなら、「技能伝承」の意味は変わる。ただし、それを確かめる材料はまだない。どの作業で、何回試して、何回成功したのか。Skel-WAM と DexTouch-WM は、規模は小さいながらその形式で数字を出している。Reward AI の次の発表で、同じ形式の数字が出てくるかどうかが注目される。
出典
- OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans(Reward AI 公式ブログ) — 2026-09
- OM-1: Frontier Robot Intelligence Learned Firsthand from Humans(Reward AI 公式 YouTube) — 2026-09-14
- About us(Reward AI 公式)
- Zipeng Fu 個人ページ
- Chen Wang 個人ページ
- DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation(RSS 2024 プロジェクトページ)
- Skel-WAM: A Hand-Skeleton-Conditioned World Action Model for Human-to-Robot Manipulation Transfer(arXiv:2609.21514) — 2026-09-18
- Skel-WAM プロジェクトページ
- DexTouch-WM: Learning Action-Conditioned Tactile World Models from Human Touch for Dexterous Robot Manipulation(arXiv:2609.20649) — 2026-09-17